
# 初始化配置
# 一、功能概述
DataHub 资产服务开箱前需要完成两项初始化:大模型配置 与 数据源(数据仓库)配置。前者决定平台的 AI 对话与推理能力,后者决定数据资产盘点、采集入仓与仓内 ETL 的目标库。两项配置完成后,即可用自然语言驱动平台完成大部分配置与查询动作。
两步之间存在依赖顺序:必须先配置大模型,之后才能通过对话让平台代为接入数据源。
# 二、前置准备
开始配置前,请准备以下入口与账号:
| 序号 | 名称 | 地址 / 要求 | 说明 |
|---|---|---|---|
| 1 | 数据开发端(开发人员后台) | https://alinesno-infra-datahub-ui.linesno.com (opens new window) | 模型配置、数据源配置与 AI 对话均在此完成 |
| 2 | 大模型服务 | 千问AI平台(TokenPlan)、DeepSeek 等任一供应商的 API 地址与密钥 | 用于「三、配置大模型」 |
| 3 | 体验数据库 | https://console.sqlpub.com/ (opens new window) 的 Serverless MySQL 实例,或自有数据库 | 用于「四、配置数据源与数据仓库」 |
💡 配置以组织为单位隔离:同一组织内的成员都能看到管理后台中的配置数据(聊天会话除外),因此组织内的模型与数据源只需配置一次。
⚠️ 上述线上地址为体验环境,请勿接入真实的生产数据库。
# 三、配置大模型
# 3.1 从「全局」进入模型配置
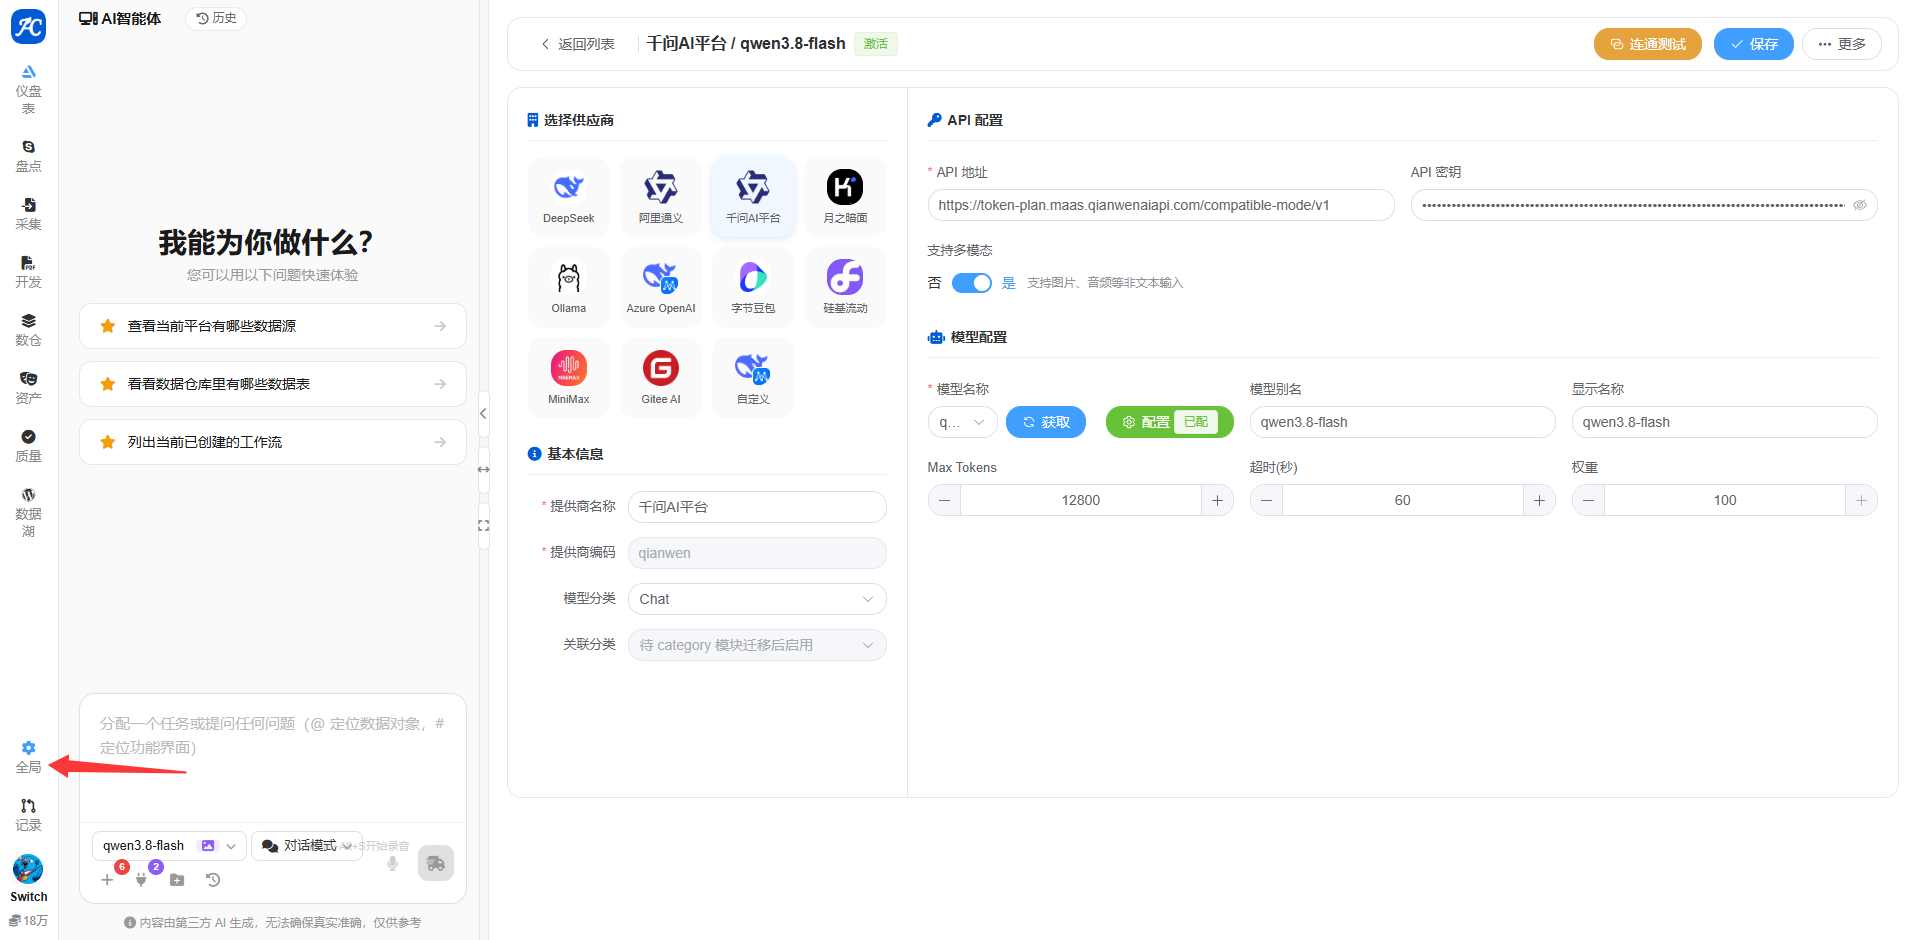
登录数据开发端,首页即为 AI 智能体对话界面。点击左侧边栏底部的 全局 入口,进入 大模型 配置页,选择供应商后填写 API 信息:
# 3.2 填写模型与 API 参数
模型建议选用 qwen3.8 系列 或 deepseek v4.1 系列。千问AI平台的 TokenPlan 支持 qwenAI 平台,性价比相对更高。
页面关键配置项如下:
| 序号 | 配置项 | 是否必填 | 说明 / 建议值 |
|---|---|---|---|
| 1 | 选择供应商 | ✅ | 可选 DeepSeek、阿里通义、千问AI平台、月之暗面、Ollama、Azure OpenAI、字节豆包、硅基流动、MiniMax、Gitee AI、自定义 |
| 2 | API 地址 | ✅ | 千问AI平台 TokenPlan 地址为 https://token-plan.maas.qianwenaiapi.com/compatible-mode/v1 |
| 3 | API 密钥 | ✅ | 在对应供应商的控制台获取,注意保密 |
| 4 | 支持多模态 | — | 需要识别图片、音频等非文本输入时打开,默认关闭 |
| 5 | 模型名称 | ✅ | 点击 获取 拉取供应商模型列表后选择,再点击 配置 确认 |
| 6 | 模型别名 / 显示名称 | ✅ | 对话输入框中用于选择模型的名称,建议与模型保持一致,如 qwen3.8-flash |
| 7 | Max Tokens | ✅ | 建议 12800 |
| 8 | 超时(秒) | — | 默认 60,无需修改 |
| 9 | 权重 | — | 默认 100,多模型轮询时用于分配比例 |
| 10 | 提供商名称 / 提供商编码 | — | 选择供应商后自动带出,如 千问AI平台 / qianwen |
| 11 | 模型分类 | ✅ | 对话模型选择 Chat |
# 3.3 设置 Temperature
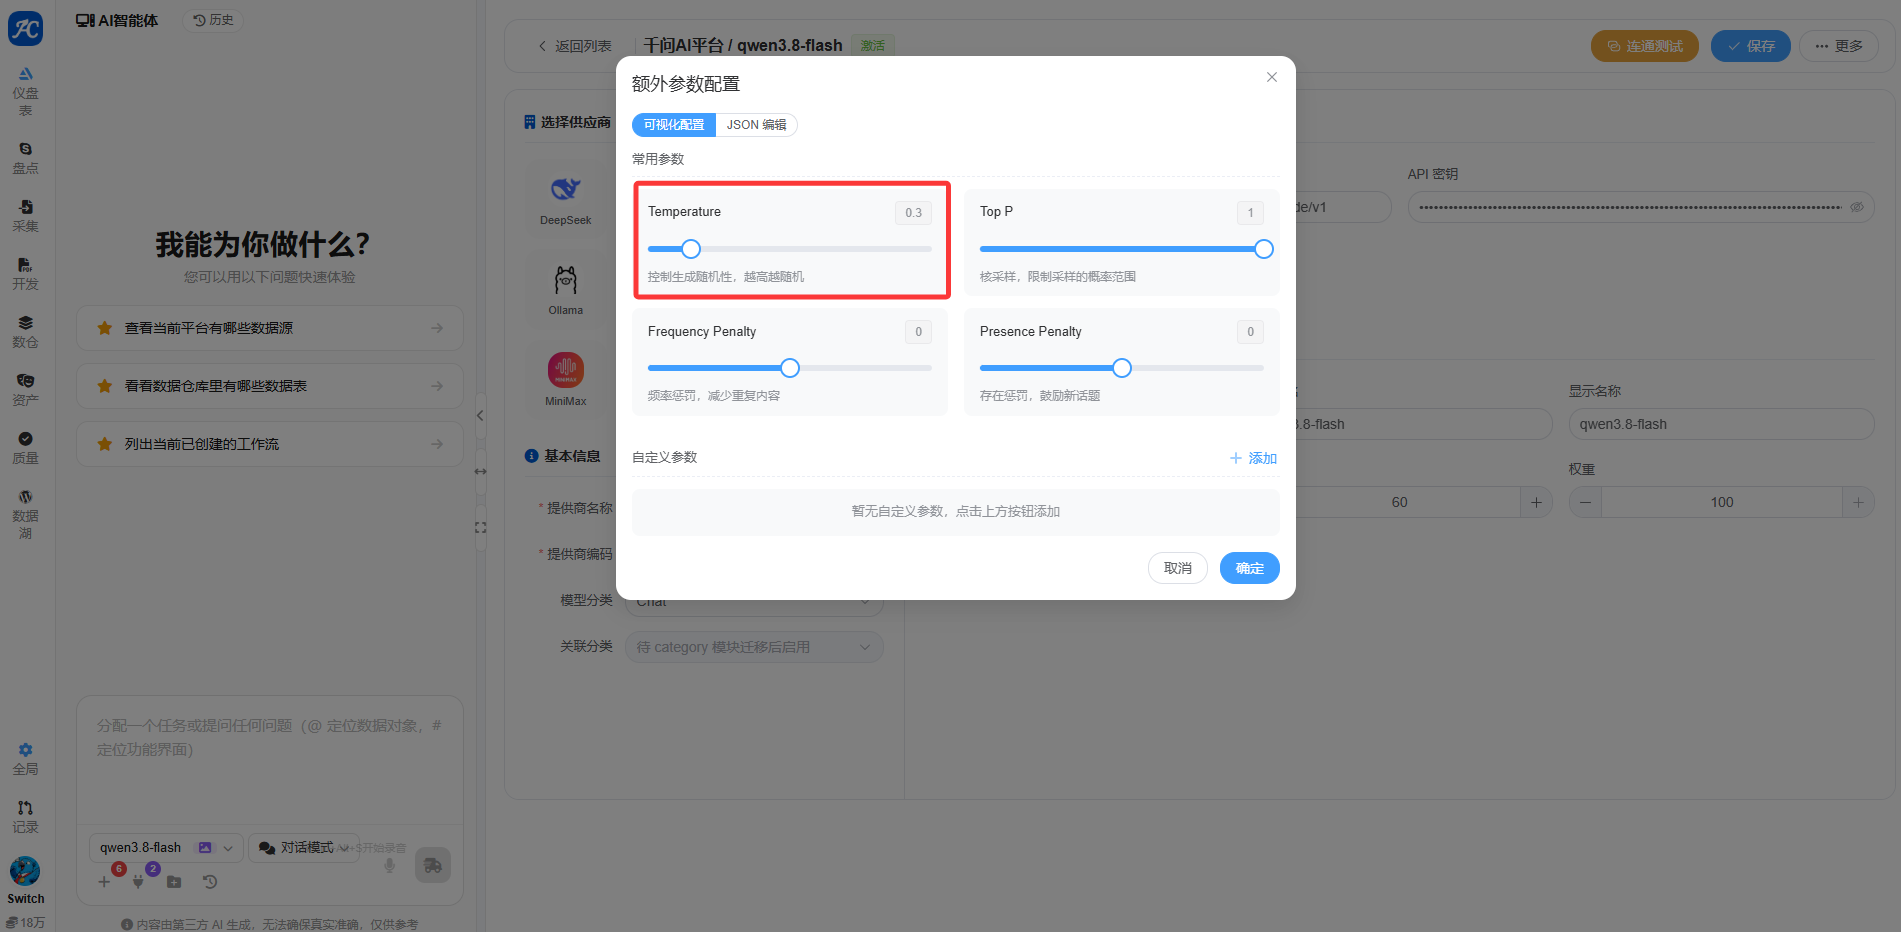
在模型配置页打开 额外参数配置(支持「可视化配置」与「JSON 编辑」两种方式),将 Temperature 调整为 0.2 ~ 0.3,其余参数保持默认:
| 序号 | 常用参数 | 界面说明 | 建议值 |
|---|---|---|---|
| 1 | Temperature | 控制生成随机性,越高越随机 | 0.2 ~ 0.3 |
| 2 | Top P | 核采样,限制采样的概率范围 | 默认 1 |
| 3 | Frequency Penalty | 频率惩罚,减少重复内容 | 默认 0 |
| 4 | Presence Penalty | 存在惩罚,鼓励新话题 | 默认 0 |
⚠️ 平台承担的是数据类任务,要求输出稳定、可复现,Temperature 不建议调高;除 Temperature 外的其它参数不建议修改。
# 3.4 连通测试与保存
参数填写完成后,依次点击右上角 连通测试 与 保存。测试通过并保存成功后,页面标题处会显示该模型的 激活 状态,表示模型已可用于对话。
# 四、配置数据源与数据仓库
平台中的「数据仓库」本质上是一个用途被标记为数据仓库的数据源:数据采集入仓、仓内 ETL 都以它为目标。
# 4.1 准备体验数据库
任选一种方式:
- Serverless 实例(推荐体验使用):访问 https://console.sqlpub.com/ (opens new window) 建立一个 Serverless MySQL 实例。
⚠️ 不要使用共享数据库——共享库没有建立 schema 的权限,平台无法完成分层建库。
- 自有数据库:使用自定义数据库,需联系管理员为服务器配置访问 IP 白名单。
# 4.2 用对话完成数据源配置
大模型配置好之后,无需逐个界面填写,直接把连接信息发给平台即可:
配置一下这个数据源,并标识为数据仓库
【这里输入 IP 地址、端口、库名、账号密码】
平台会解析意图、创建数据源并标记用途,随后回复当前组织的数据源清单,可据此确认哪个库是数据仓库:
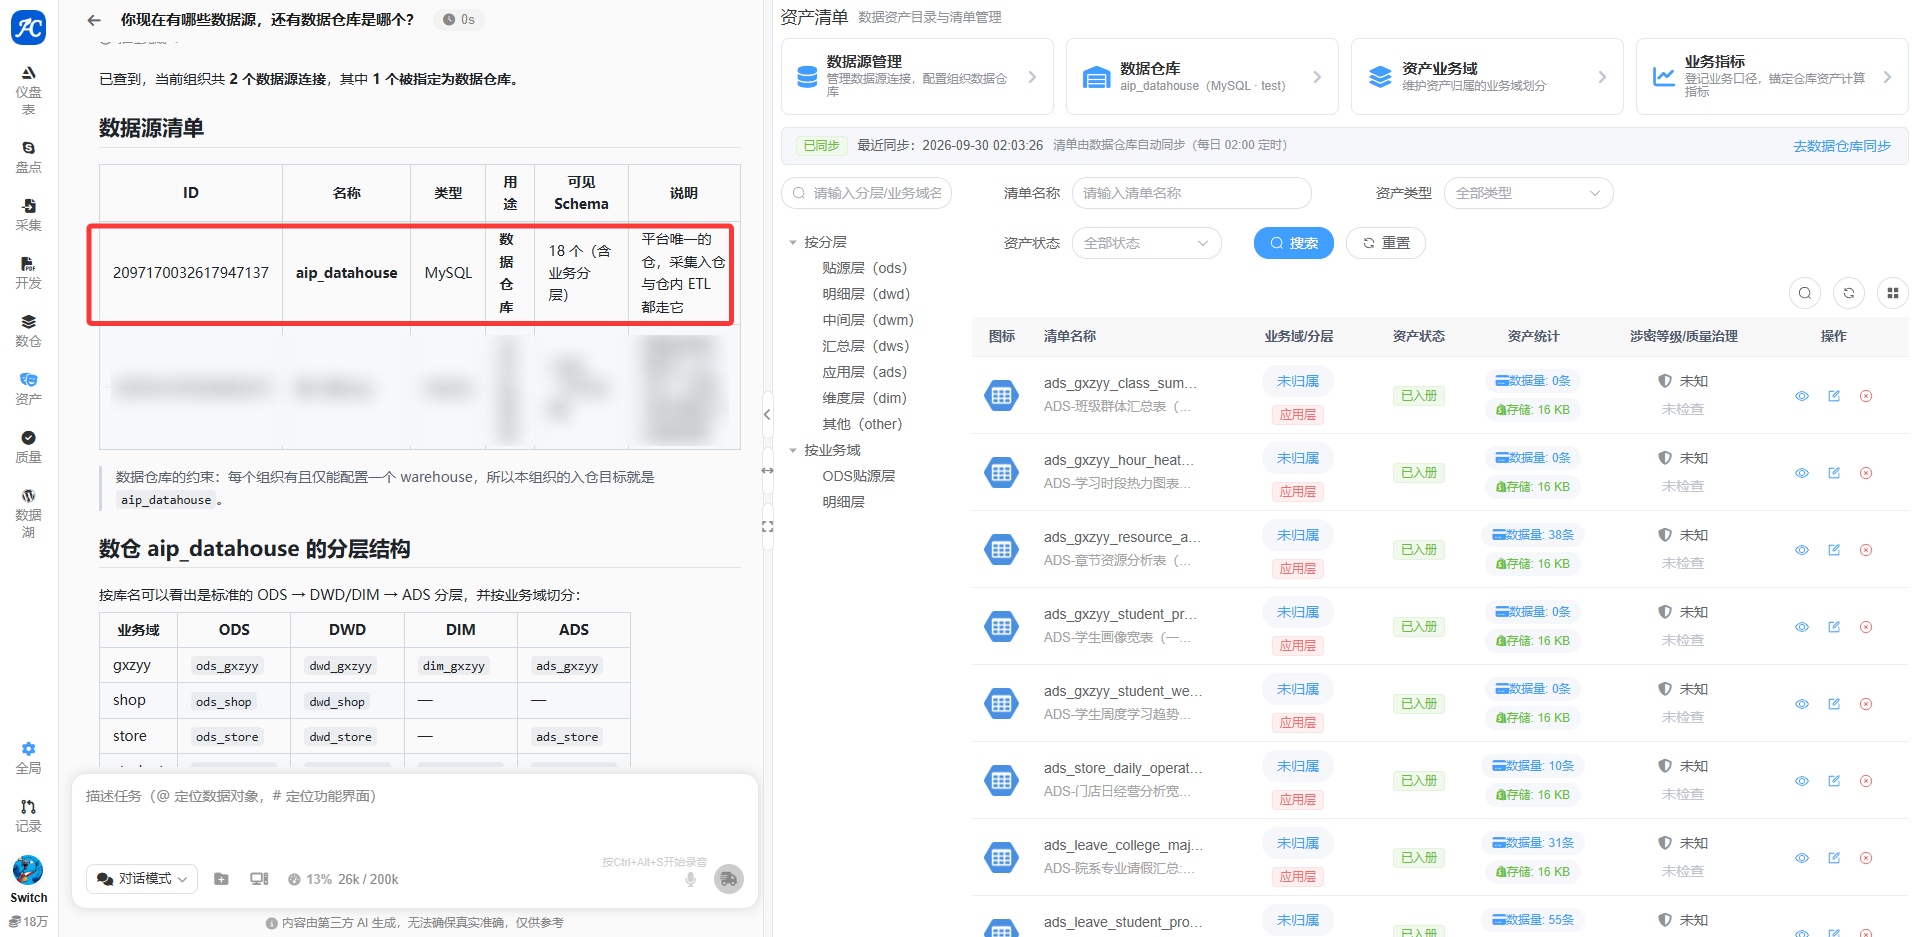
⚠️ 每个组织 有且仅能 配置一个数据仓库(warehouse),本组织的入仓目标即该数据源。标记前请确认库选得没错。
# 4.3 打开管理界面核对
添加完成后,可以继续对平台说:
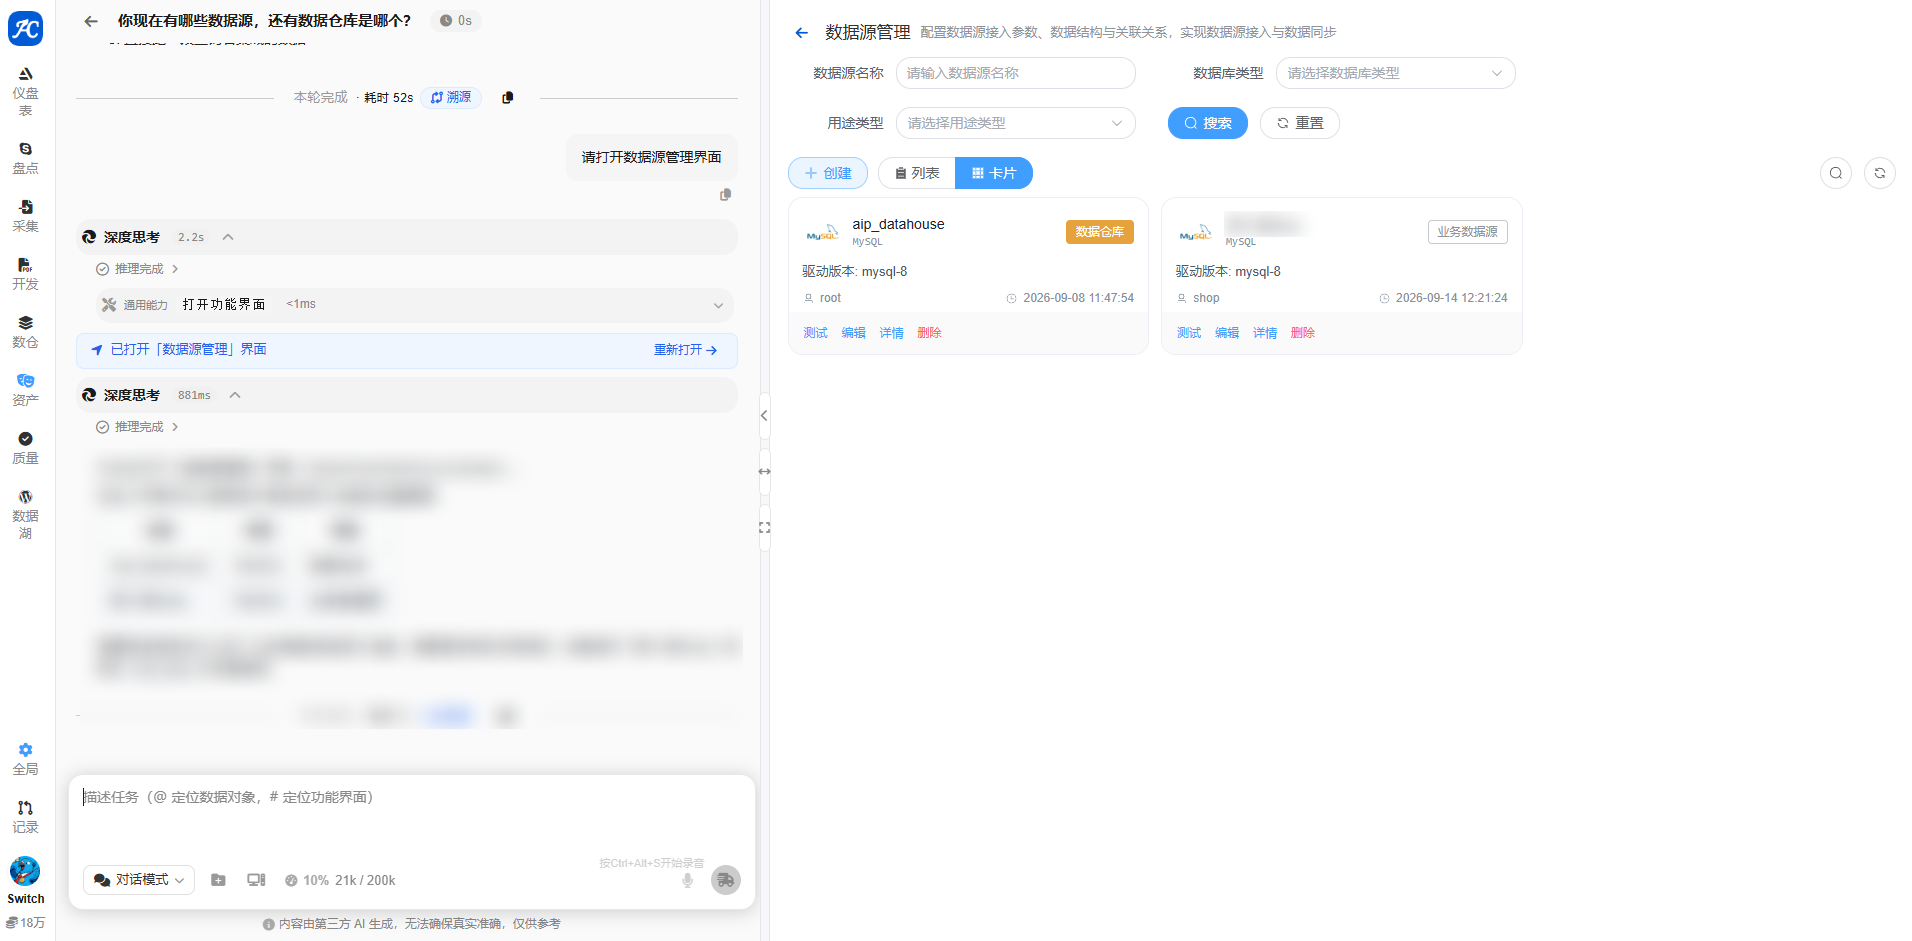
请打开数据源管理界面。
平台会直接跳转并打开 数据源管理 界面。在数据源卡片上可查看用途标签(数据仓库 / 业务数据源)、数据库类型与驱动版本、连接账号、创建时间,并可执行 测试 / 编辑 / 详情 / 删除:
# 五、使用方式
至此初始化基本完成。后续有两种操作路径,二者结果一致,可按习惯选择:
- 对话优先:在首页输入框直接描述任务,其中
@用于定位数据对象、#用于定位功能界面;首页也提供了「查看当前平台有哪些数据源」「看看数据仓库里有哪些数据表」「列出当前已创建的工作流」等快捷问题可先体验。 - 界面优先:如果觉得 AI 对话不方便或麻烦,从 全局 进入对应管理界面手动维护即可。
# 六、注意事项
- 配置顺序不可颠倒:数据源的创建与识别依赖大模型,未配置模型时对话入口无法代为完成配置,只能走界面手动录入。
- 组织隔离范围:模型与数据源配置对组织内成员共享,切换组织后需要重新配置;聊天会话不共享。
- 体验环境:线上地址为体验环境,禁止连接真实生产数据库;确需接入自有库,先找管理员配置 IP 白名单。
- 数据仓库唯一性:一个组织只能有一个数据仓库用途的数据源,采集入仓与仓内 ETL 都指向它。
- 参数保持默认:Temperature 固定 0.2 ~ 0.3、Max Tokens 建议 12800,其余参数不要调整,否则会影响数据类任务的稳定性。